Управление доступом AI-агентов через PAM
изображение: recraft
За несколько лет в инфраструктуре большинства компаний появился новый тип пользователя, о котором еще недавно никто всерьез не думал с точки зрения контроля доступа. Речь про AI-агентов — программы, которые самостоятельно принимают решения о том, куда обратиться и какие данные забрать, чтобы выполнить задачу человека.
Формально AI-агенты не сотрудники и не сервисные скрипты, но по факту делают то же самое: заходят в корпоративные системы, читают и иногда изменяют данные, действуют от чьего-то имени. И именно поэтому классические подходы к управлению привилегированным доступом, изначально придуманные для людей и для стабильных сервисных аккаунтов, начинают трещать по швам, когда их пытаются применить к агентам без адаптации.
Современные PAM-платформы отвечают на этот вызов не единым готовым рецептом, а набором принципов, которые постепенно становятся стандартом отрасли. Стоит пройтись по ключевым из них.
Первый принцип — собственная машинная идентичность для каждого агента вместо одного общего сервисного аккаунта на всю интеграцию. Звучит как небольшая деталь, но на практике именно она определяет, насколько управляемой останется система, когда агентов станет не один и не два, а несколько десятков. С отдельной идентичностью проще ограничивать права конкретного агента, видеть в логах, какие действия совершил именно он, а не абстрактный «сервисный пользователь», и мгновенно отозвать доступ без влияния на остальные интеграции.
Второй принцип — краткоживущие, а не постоянные учетные данные. Вместо статического пароля, который живет месяцами, агент или обслуживающий его сервис получает временный токен или сертификат с ограниченным сроком действия. PAM выдает его по запросу и автоматически отзывает, так что даже перехваченный секрет становится бесполезным уже через непродолжительное время.
Третий принцип — минимально необходимые привилегии, определяемые не для человека, а для конкретной задачи агента. Агенту, который должен только читать тикеты в Jira, незачем иметь права на их изменение или удаление, даже если исторически сервисный аккаунт, из которого выросла интеграция, был создан с куда более широким набором прав «на всякий случай».
Четвертый принцип — полный аудит действий агента на уровне отдельных операций, а не только факта выдачи секрета. Это то, что впоследствии позволяет разобрать любой инцидент и понять не просто «кому был выдан пароль», а какое именно действие в целевой системе было выполнено от имени агента и на основании какого запроса.
Вместе эти четыре принципа складываются в один тезис: AI-агента стоит рассматривать не как исключение из правил доступа, а как еще одного пользователя инфраструктуры, к которому применяются те же принципы контроля, только в динамике, автоматически и без участия человека на каждом шаге. Дальше стоит показать, как эти принципы выглядят не в теории, а в конкретной архитектуре, которая уже прошла проверку на практике.
Представьте уже вполне типовую для современных реалий ситуацию. Три часа ночи, разработчик из вашей команды просит AI-агента посмотреть открытые тикеты и подготовить сводку для утреннего дейли. Агент идет в Jira, забирает данные, формирует отчет. Все работает, все довольны.
А теперь ключевой вопрос. Чем именно агент авторизовался в Jira?
Если ответ «каким-то паролем, который где-то прописан», это признак классической проблемы со статическими секретами. Именно о ней и пойдет речь дальше.
Что такое MCP-сервер и при чем тут секреты
MCP (Model Context Protocol) — открытый протокол, который позволяет AI-агенту (например, Claude Code или другому инструменту с поддержкой MCP) обращаться к внешним системам не напрямую, а через промежуточный сервис, MCP-сервер.
Такой сервер умеет говорить с конкретной системой. Jira, GitLab, Confluence, корпоративная CRM, база данных, облачный API или внутренний сервис мониторинга, вариантов множество. Агент отправляет MCP-серверу запрос вида «покажи задачи», а MCP-сервер сам преобразует его в вызов REST API целевой системы, используя учетные данные для аутентификации.
И именно здесь возникает главный вопрос. Где хранятся эти учетные данные?
Первый, наивный подход
В большинстве реализаций, которые встречаются на практике, пароль или API-токен просто прописывается в конфигурации MCP-сервера, в переменных окружения или в файле настроек.
Это быстро работает, но воспроизводит классическую проблему статических секретов.
- Значение не меняется месяцами.
- Одинаково для всех вызовов.
- Доступно любому, кто может прочитать конфигурацию контейнера или процесса.
При компрометации контейнера с MCP-сервером или его некорректной настройке, например лишний открытый порт или избыточные права на файловую систему, пароль от целевой системы утекает вместе с ним.
Почему просто положить секрет в PAM не решает проблему
Убрать пароль из конфигурации и подтянуть его из PAM звучит как очевидное решение. Но если сделать это буквально, один раз запросить секрет у PAM при старте MCP-сервера и закэшировать его в переменной окружения или локальном файле, по сути, ничего не меняется.
- Секрет все равно живет в среде выполнения MCP-сервера неограниченное время.
- PAM не может его отозвать или заменить без перезапуска сервиса.
- Ротация паролей на стороне PAM становится бессмысленной. MCP-сервер продолжит работать со старым значением, пока кто-то вручную не перезапустит контейнер.
В результате PAM используется формально. Секрет действительно хранится в защищенном хранилище, но фактически так же статично находится в рабочей среде сервиса, просто с дополнительным шагом при старте.
Здесь уместен и более общий вопрос. Зачем вообще нужен именно PAM, а не просто секрет-менеджер вроде тех, что уже встроены во многие облачные платформы и точно так же умеют хранить и раздавать секреты по запросу. Разница в том, что PAM исторически строится вокруг сессии и субъекта доступа, а не только вокруг самого секрета. Во-первых, это сессионный контроль: PAM отслеживает не только факт выдачи секрета, но и то, что происходит в рамках сессии, использующей этот доступ. Во-вторых, это выдача доступа по принципу just-in-time, когда секрет или сессия создаются под конкретную задачу и автоматически закрываются по ее завершении. В-третьих, и это особенно важно для AI-агентов, это единая точка аудита, в которой действия людей и машинных идентичностей фиксируются в одной модели данных, а не в разрозненных логах разных систем.
Как это должно быть устроено: отдельный сервис-посредник
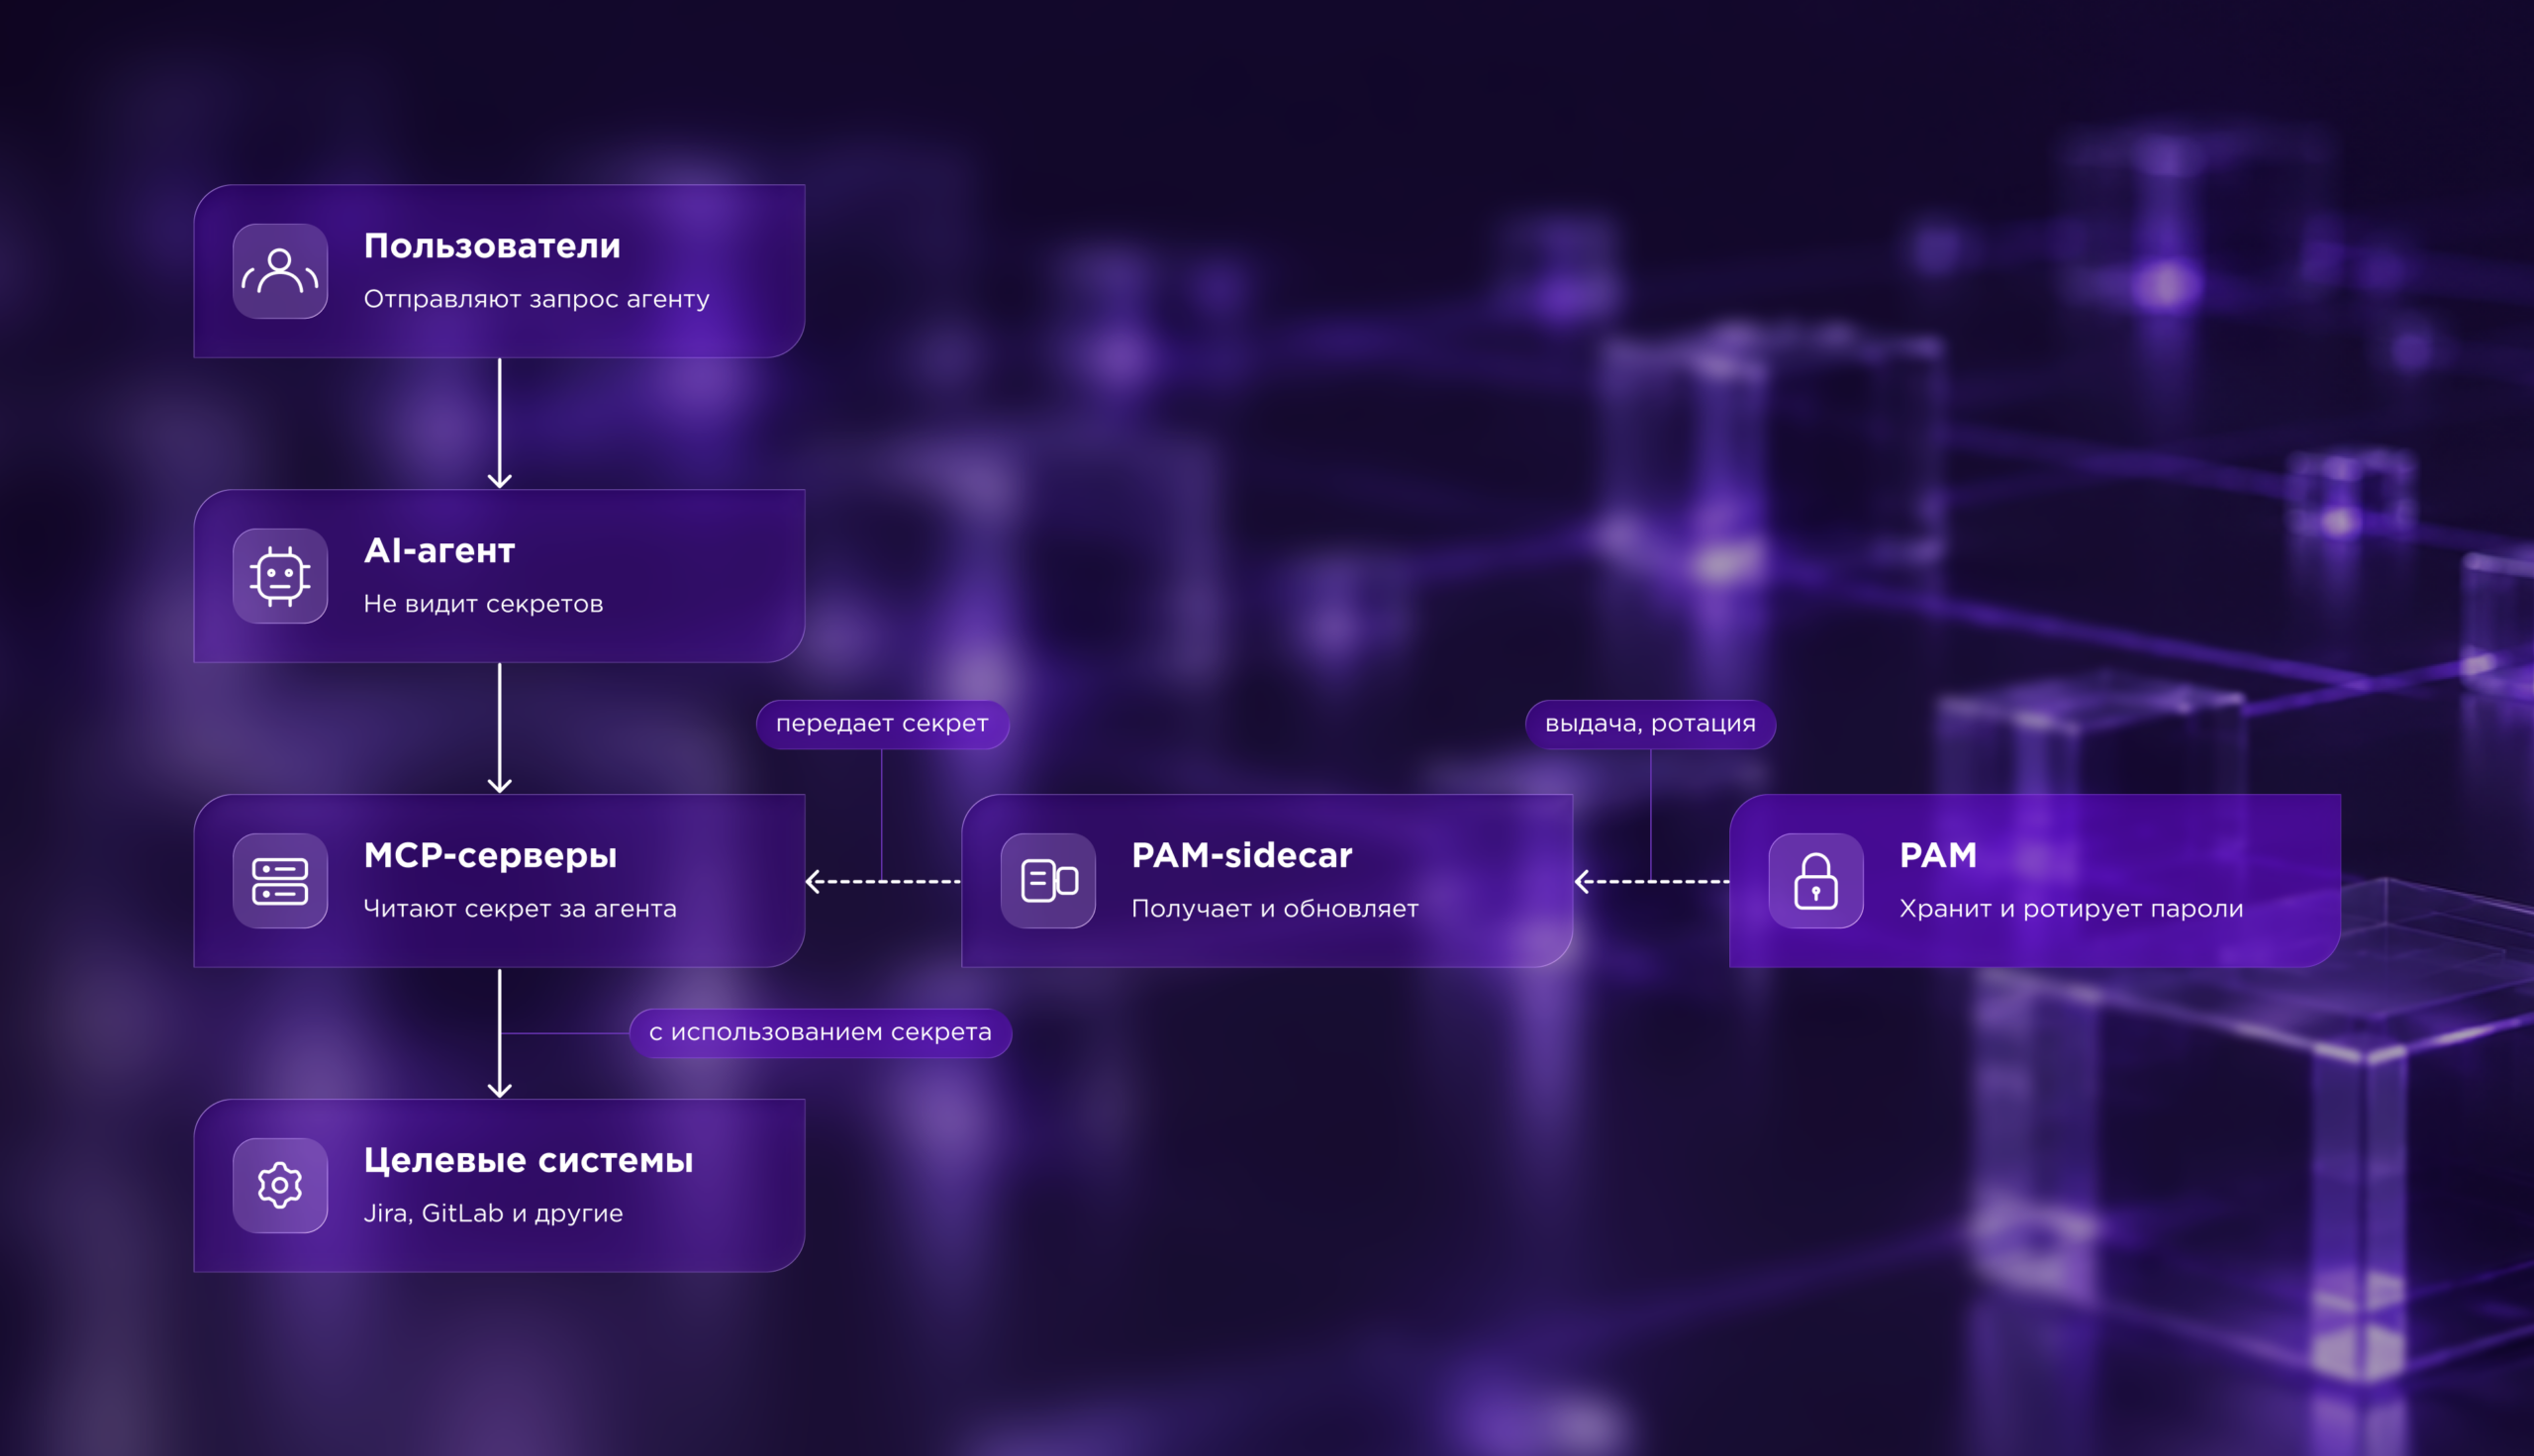
Правильная схема требует отдельного компонента, который берет на себя постоянную синхронизацию секретов. Такой компонент часто называют PAM-sidecar.
Это отдельный контейнер в той же Docker-сети, что и MCP-серверы, но с собственной, строго ограниченной зоной ответственности. Он:
- Получает актуальные секреты из PAM по REST API, используя механизмы временной аренды доступа к секрету с ограниченным сроком действия.
- Отслеживает изменения секретов на стороне PAM через периодический опрос или подписку на события и не дает MCP-серверам работать с устаревшими значениями.
- Обновляет секреты в общем хранилище, доступном всем MCP-серверам, которое существует только в оперативной памяти и никогда не записывается на диск.
- Не знает о бизнес-логике MCP-серверов и не имеет доступа к их API, только записывает файлы с секретами в общий том.
Сами MCP-серверы при каждом обращении к целевой системе читают актуальный секрет из своего файла в общем томе и используют его для аутентификации в REST API.
Важный момент. Большинству MCP-серверов не нужно перезапускаться, чтобы подхватить новый пароль. Они устроены так, что сверяются с актуальным значением каждый раз, когда обращаются к целевой системе, то есть новый секрет начинает использоваться сразу, без остановки сервиса и без вмешательства человека.
AI-агент во всей этой цепочке взаимодействует только с MCP-серверами через их собственный API и не имеет никакого доступа ни к секретам, ни к внутренней сети, где происходит их обновление.
От каких атак защищает такая архитектура
Полезно разобрать не только устройство схемы, но и конкретные сценарии компрометации, от которых она защищает, потому что именно это, а не архитектурная красота, оправдывает дополнительный компонент в инфраструктуре.
Компрометация контейнера MCP-сервера. Уязвимость в самом MCP-сервере или в одной из его зависимостей может дать атакующему выполнение кода внутри контейнера. При наивном подходе это сразу означает доступ к статическому паролю, валидному неограниченное время. При описанной схеме в контейнере MCP-сервера секрета вообще нет, он только читает его из общего тома в момент обращения. Максимум, что получает атакующий, скомпрометировав именно этот контейнер, — секрет с ограниченным сроком аренды, который в любой момент можно отозвать через PAM, не дожидаясь, пока кто-то вручную сменит пароль.
Утечка образа или конфигурации из CI/CD. Образы контейнеров и файлы конфигурации нередко оказываются в реестрах, бэкапах или логах сборки шире, чем предполагалось. Если пароль зашит в переменных окружения или Docker-конфиге, он утекает вместе с образом и остается действительным до ручной смены. В этой архитектуре секретов в образе MCP-сервера нет в принципе, они существуют только во время выполнения, в оперативной памяти, так что утечка образа или конфигурации сама по себе ничего атакующему не дает.
Инсайдер с доступом к хосту или логам. Сотрудник с легитимным административным доступом к серверу при наивной схеме может прочитать пароль напрямую из конфигурации любого запущенного процесса, и это действие никак не будет зафиксировано. Здесь доступ к актуальному секрету физически ограничен одним общим томом, видимым только нужным контейнерам, а каждая выдача секрета из PAM фиксируется в журнале аудита, то есть даже у легитимного администратора инфраструктуры попытка добраться до реального пароля оставляет след.
Латеральное перемещение через одну скомпрометированную интеграцию. Если один MCP-сервер взломан и все интеграции в компании исторически используют похожий по способу хранения или даже общий секрет, атакующий получает плацдарм для движения дальше по инфраструктуре. В этой модели у каждого MCP-сервера свой файл секрета со строго ограниченной областью видимости, поэтому взлом, например, Jira MCP-сервера не дает автоматического доступа к паролям GitLab MCP-сервера или подключенной базы данных.
Как это выглядит на практике
Пользователь пишет агенту «покажи мои задачи в Jira». Агент отправляет запрос в Jira MCP-сервер. Тот читает актуальный пароль из общего тома, обращается к Jira REST API, возвращает результат агенту, а тот отдает его пользователю.
Параллельно точно так же может работать GitLab MCP-сервер, коннектор к базе данных или интеграция с внутренней системой тикетов. Количество и состав MCP-серверов ничем не ограничены, каждый со своим набором секретов и правилами ротации, заданными в PAM.
Если пароль от Jira меняется, по расписанию или в рамках инцидента, PAM-sidecar получает новое значение, обновляет файл в общем томе, и Jira MCP-сервер начинает использовать его при следующем обращении. Никаких ручных перезапусков, никакой рассинхронизации между тем, что хранится в PAM, и тем, что реально используется для аутентификации.
Что это дает
- Секрет не хранится на диске и в конфигурации. Он находится только в оперативной памяти общего хранилища и исчезает вместе с ней.
- Ротация паролей в PAM реально работает. Изменение секрета сразу отражается на интеграциях без ручных вмешательств.
- AI-агент изолирован от секретов. Ни на одном этапе запроса у него нет доступа к учетным данным.
- Изоляция между интеграциями. Компрометация одного MCP-сервера не дает доступа к паролям других систем, у каждого свой файл секрета с ограниченной областью видимости.
- Масштабируемость. Подключение нового сервиса, почты, ERP, облачного хранилища, сводится к добавлению еще одного MCP-сервера и правила выдачи секрета в PAM, без изменения архитектуры.
- Аудит и расследование инцидентов. Все операции получения и обновления секретов фиксируются в логах PAM.
Отдельный практический момент, важный для российской ИБ-аудитории, это соответствие требованиям регуляторов. Если через такие MCP-интеграции AI-агент получает доступ к персональным данным, это уже зона действия 152-ФЗ и необходимость выполнения требований к защите соответствующих информационных систем. Такая архитектура облегчает выполнение требований приказов ФСТЭК России по защите информации в части учета и контроля действий привилегированных учетных записей, поскольку каждое действие AI-агента, совершенное через MCP-сервер, оказывается прослеживаемым до конкретного секрета, сессии и момента времени. А для организаций, ориентированных на использование российских PAM-решений в рамках общего курса на импортозамещение средств защиты информации, это означает, что контроль доступа AI-агентов можно встроить в уже существующий контур PAM, не выстраивая для них отдельную, параллельную систему управления доступом.
Что дальше
AI-агенты уже стали полноценными «пользователями» корпоративной инфраструктуры, и подходы к управлению их доступом должны эволюционировать вместе с ними, следуя тем же принципам собственной идентичности, коротких сроков жизни секретов, минимальных привилегий и полного аудита, с которых начиналась эта статья. Статические секреты в конфигурациях — технический долг, который рано или поздно придется оплачивать.
Архитектура с PAM-sidecar — конкретный пример того, как эти принципы реализуются на практике: она делает работу AI-агентов с внутренними системами безопасной и управляемой, с реальной ротацией секретов, изоляцией и аудитом.
Автор: Дмитрий Симак, менеджер продукта PAM Infrascope, компания NGR Softlab